Overview of D.A.V.I.D.
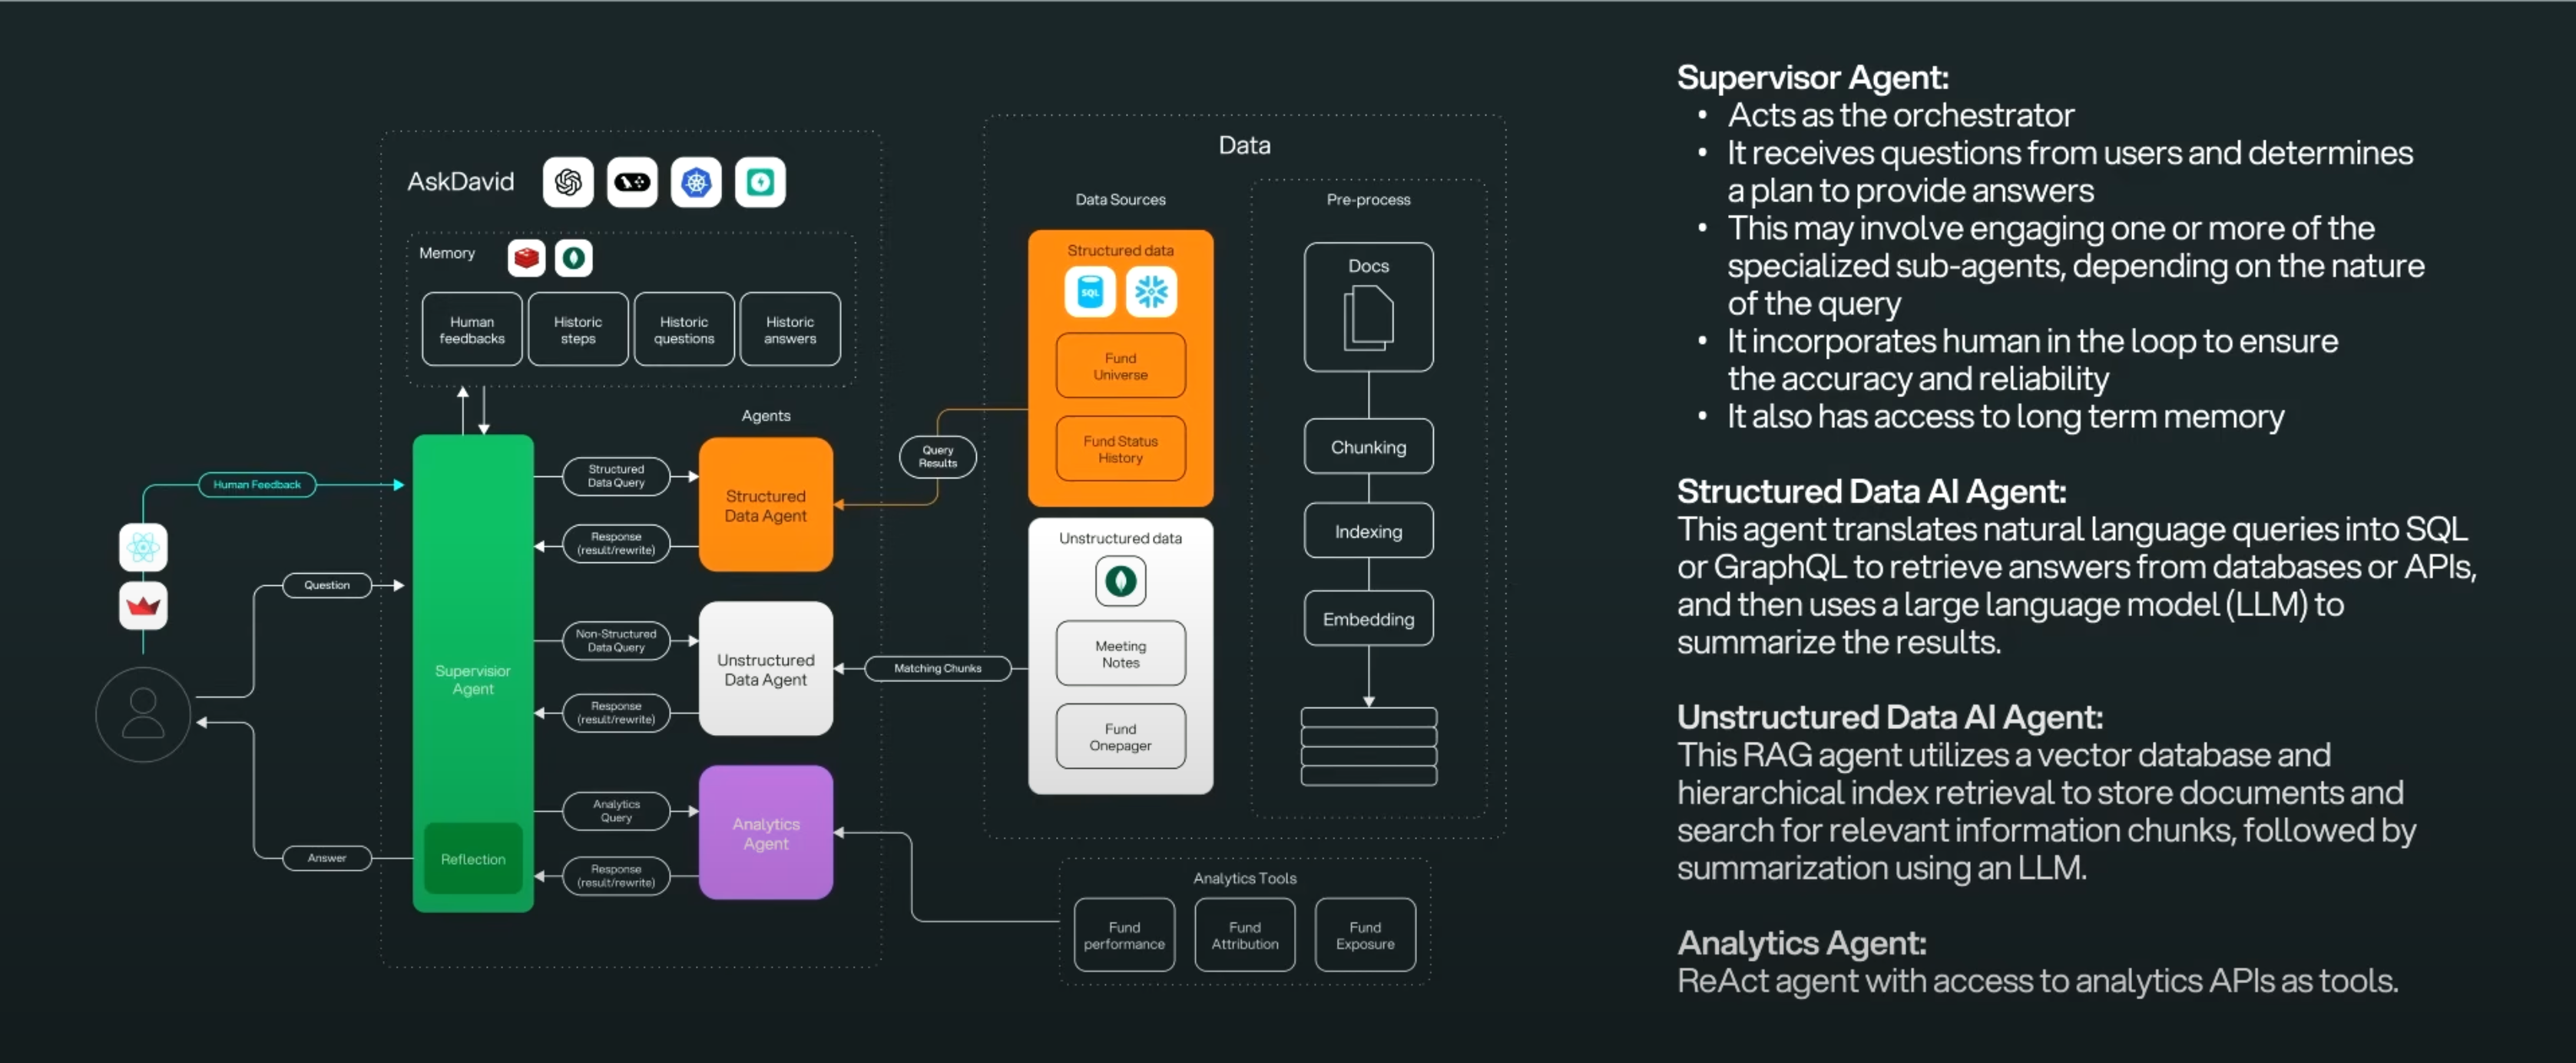
D.A.V.I.D. (Data Analysis and Visualization Intelligence Dashboard) is JPMorgan Chase’s sophisticated AI-powered system built using LangGraph for automated financial data analysis and visualization. This system demonstrates how large financial institutions leverage multi-agent architectures to process complex financial queries and generate actionable insights.
System Architecture
Core Components
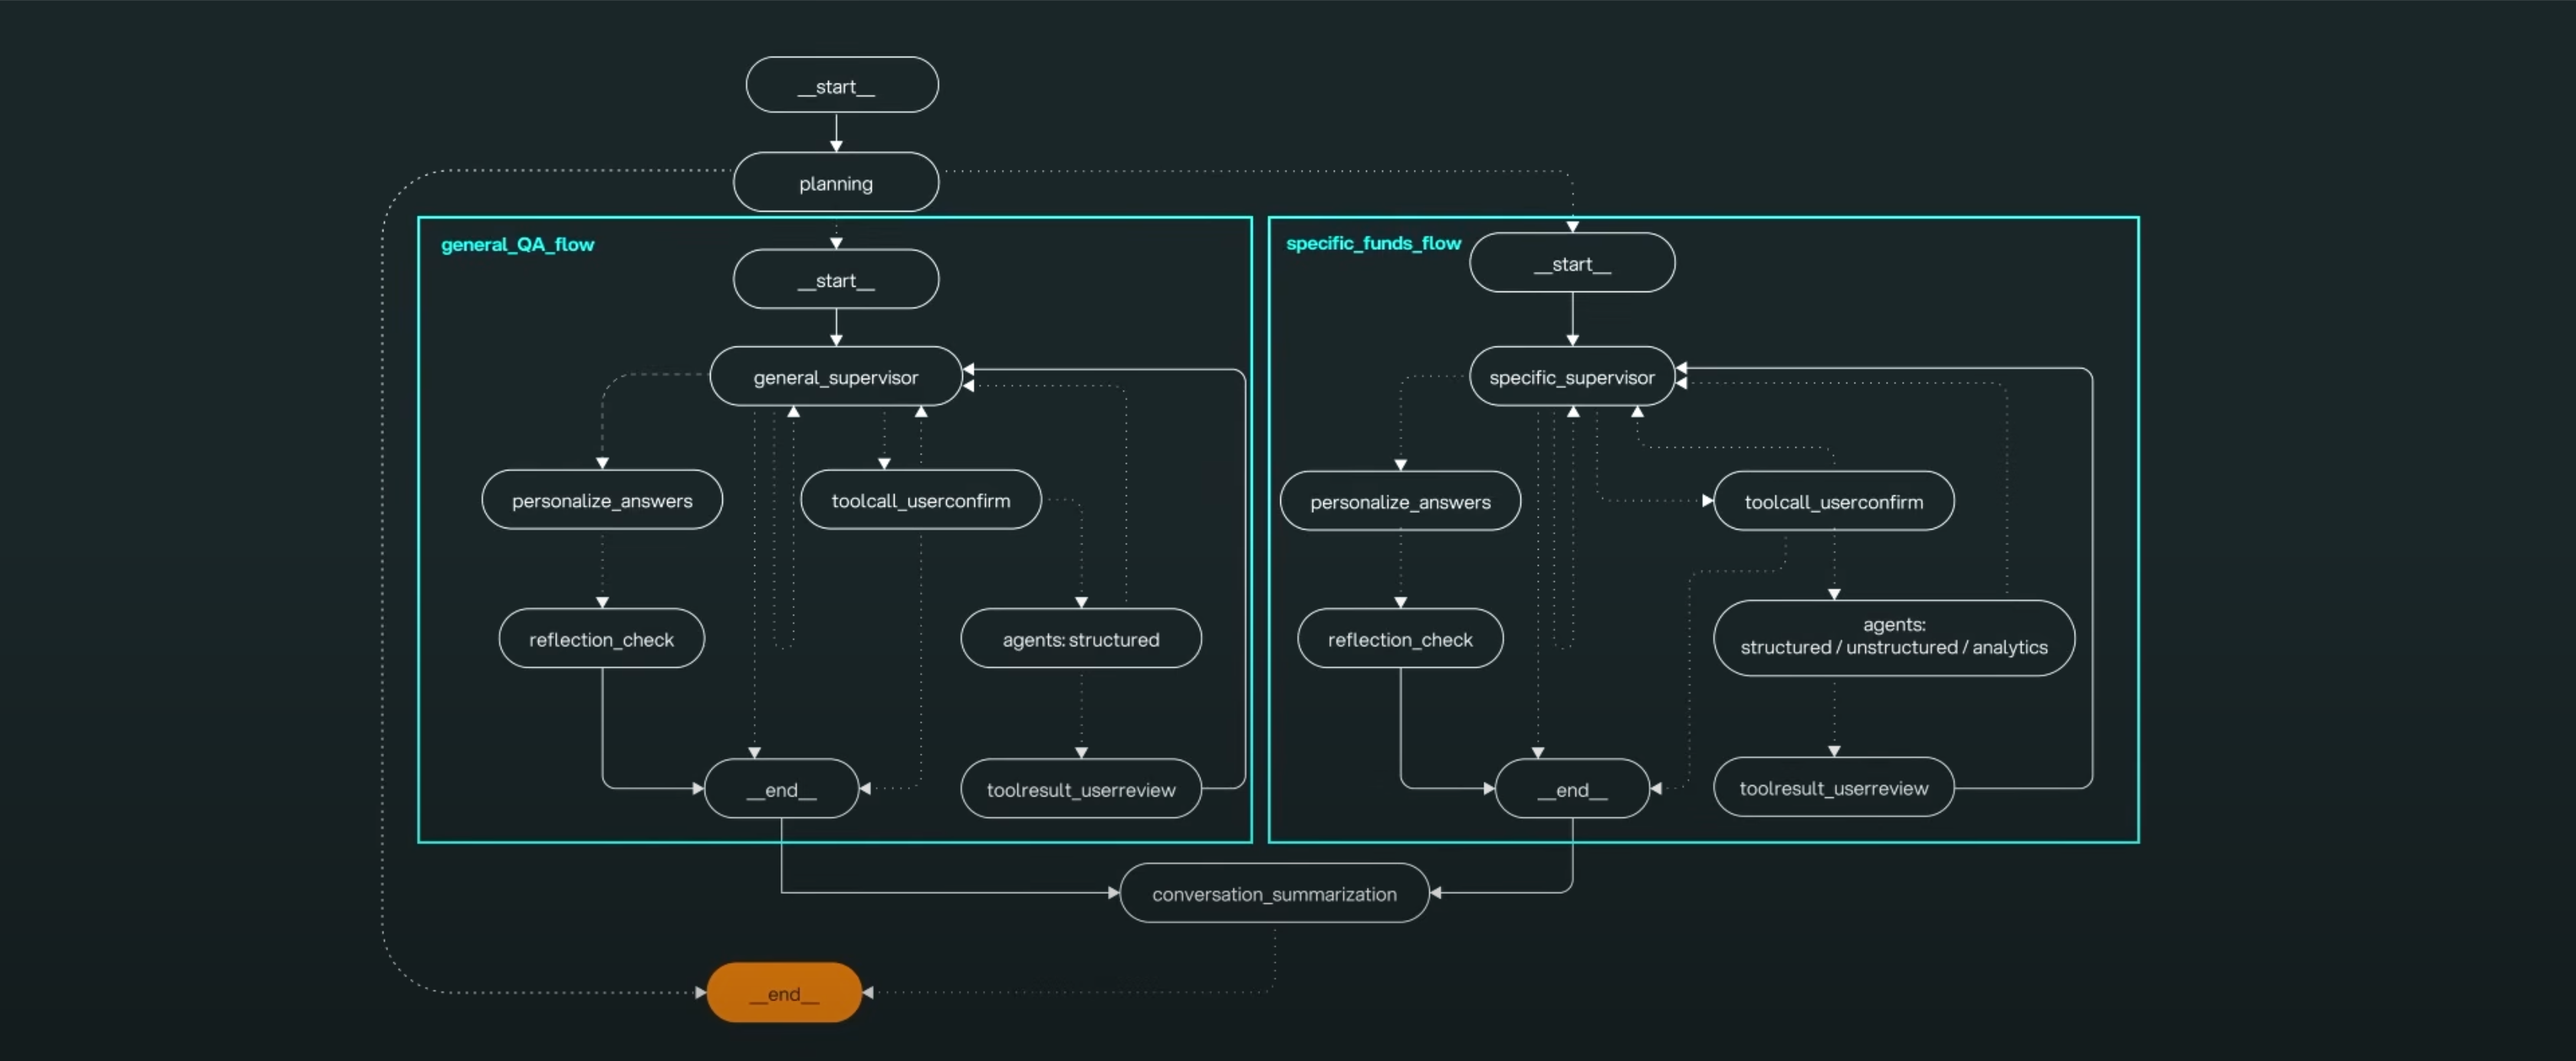
- Multi-Agent Framework: Built on LangGraph’s StateGraph architecture
- Specialized Agents: Domain-specific agents for different financial analysis tasks
- Tool Integration: Multiple financial data tools and APIs
- Visualization Engine: Automated chart and report generation
- Quality Assurance: Built-in validation and review mechanisms
Agent Architecture (Based on LangGraph Diagram)
1. Query Processing Agent
Purpose: Initial query interpretation and routing
- Responsibilities:
- Parse natural language financial queries
- Identify query type (market analysis, risk assessment, portfolio review, etc.)
- Extract key parameters (time ranges, securities, metrics)
- Route to appropriate specialist agents
Implementation Pattern:
def query_processor_node(state: DavidState):
    """
    Processes incoming financial queries and determines routing
    """
    query = state["user_query"]
    query_type = classify_financial_query(query)
    parameters = extract_financial_parameters(query)

    return {
        "query_type": query_type,
        "parameters": parameters,
        "routing_decision": determine_agent_routing(query_type)
    }
2. Data Retrieval Agent
Purpose: Fetch relevant financial data from multiple sources
- Data Sources:
- Market data feeds (Bloomberg, Reuters)
- Internal transaction databases
- Risk management systems
- Regulatory reporting databases
- Capabilities:
- Real-time market data retrieval
- Historical data analysis
- Cross-reference validation
- Data quality checks
3. Analysis Agent
Purpose: Perform sophisticated financial analysis
- Analysis Types:
- Portfolio performance analysis
- Risk metrics calculation
- Market trend analysis
- Regulatory compliance checks
- Stress testing scenarios
- Tools Used:
- Quantitative analysis libraries
- Risk modeling frameworks
- Machine learning models
- Statistical analysis tools
4. Visualization Agent
Purpose: Generate charts, graphs, and visual reports
- Visualization Types:
- Performance dashboards
- Risk heat maps
- Trend analysis charts
- Regulatory reports
- Executive summaries
- Output Formats:
- Interactive web dashboards
- PDF reports
- PowerPoint presentations
- Excel spreadsheets
5. Quality Assurance Agent
Purpose: Validate results and ensure accuracy
- Validation Checks:
- Data consistency verification
- Calculation accuracy review
- Regulatory compliance validation
- Cross-reference with historical patterns
- Anomaly detection
Workflow Implementation (Based on Graph Workflow)
Phase 1: Query Intake and Classification
User Query → Query Processor → Classification → Parameter Extraction
Phase 2: Data Collection Strategy
Classification → Data Strategy → Multi-Source Retrieval → Data Validation
Phase 3: Analysis Pipeline
Clean Data → Risk Analysis → Performance Analysis → Compliance Check
Phase 4: Visualization Generation
Analysis Results → Chart Selection → Visualization Creation → Format Optimization
Phase 5: Quality Assurance and Delivery
Generated Content → QA Review → Error Detection → Final Output
State Management
DavidState Structure
class DavidState(TypedDict):
    # Input Processing
    user_query: str
    query_type: str
    parameters: Dict[str, Any]

    # Data Management
    raw_data: List[Dict]
    processed_data: Dict[str, Any]
    data_quality_score: float

    # Analysis Results
    analysis_results: Dict[str, Any]
    risk_metrics: Dict[str, float]
    performance_metrics: Dict[str, float]

    # Visualization
    chart_specifications: List[Dict]
    generated_visualizations: List[str]

    # Quality Control
    validation_results: Dict[str, bool]
    error_flags: List[str]
    confidence_score: float

    # Output
    final_report: str
    executive_summary: str
Key Implementation Features
1. Conditional Routing
The system uses sophisticated routing logic to direct queries to the most appropriate analysis pipeline:
def routing_logic(state: DavidState) -> str:
    query_type = state["query_type"]

    if query_type in ["portfolio_analysis", "performance_review"]:
        return "portfolio_agent"
    elif query_type in ["risk_assessment", "stress_test"]:
        return "risk_agent"
    elif query_type in ["market_analysis", "trend_analysis"]:
        return "market_agent"
    elif query_type in ["compliance", "regulatory"]:
        return "compliance_agent"
    else:
        return "general_analysis_agent"
2. Error Handling and Fallbacks
Robust error handling ensures system reliability:
def error_handler_node(state: DavidState):
    if state.get("error_flags"):
        # Implement fallback strategies
        return fallback_analysis(state)
    return state
3. Human-in-the-Loop Integration
Critical decisions and high-stakes analyses include human review:
def human_review_required(state: DavidState) -> str:
    if (state["confidence_score"] < 0.8 or
        "high_risk" in state["analysis_results"] or
        state["query_type"] == "regulatory_filing"):
        return "human_review"
    return "auto_approve"
Tools and Integrations
1. Market Data Tools
- Bloomberg API: Real-time market data
- Reuters Eikon: News and analytics
- Internal Market Data: Proprietary feeds
2. Risk Analysis Tools
- Monte Carlo Simulation: Scenario analysis
- VaR Calculators: Value at Risk assessment
- Stress Testing: Regulatory stress tests
3. Visualization Tools
- Plotly/Dash: Interactive charts
- D3.js: Custom visualizations
- PowerBI: Executive dashboards
4. Data Processing Tools
- Pandas/NumPy: Data manipulation
- Apache Spark: Large-scale processing
- SQL Databases: Data storage and retrieval
Security and Compliance Considerations
1. Data Security
- End-to-end encryption for all data transfers
- Role-based access control (RBAC)
- Audit logging for all system interactions
- Secure API endpoints with authentication
2. Regulatory Compliance
- SOX compliance for financial reporting
- GDPR compliance for data privacy
- Basel III compliance for risk reporting
- SEC compliance for market analysis
3. Data Governance
- Data lineage tracking
- Quality metrics monitoring
- Retention policy enforcement
- Classification and tagging
Performance Optimizations
1. Caching Strategies
- Redis cache for frequently accessed market data
- Database query optimization
- Pre-computed analysis results for common queries
2. Parallel Processing
- Concurrent data retrieval from multiple sources
- Parallel analysis pipelines for different metrics
- Asynchronous visualization generation
3. Resource Management
- Dynamic scaling based on query volume
- Load balancing across analysis nodes
- Memory optimization for large datasets
Benefits Achieved
1. Operational Efficiency
- 90% reduction in manual analysis time
- 24/7 availability for critical analysis requests
- Consistent quality across all reports
2. Risk Management Enhancement
- Real-time risk monitoring capabilities
- Automated stress testing execution
- Early warning systems for market anomalies
3. Regulatory Compliance
- Automated compliance checking for all analyses
- Standardized reporting formats
- Audit trail maintenance for all decisions
4. Business Intelligence
- Faster decision making with instant analysis
- Comprehensive insights from multi-source data
- Predictive analytics for market trends
Lessons Learned and Best Practices
1. Agent Design Principles
- Single Responsibility: Each agent has a clear, focused purpose
- Loose Coupling: Agents communicate through well-defined state
- Error Resilience: Comprehensive error handling and recovery
2. Data Management
- Data Quality First: Implement robust validation before analysis
- Source Diversity: Use multiple data sources for cross-validation
- Real-time Updates: Ensure data freshness for critical decisions
3. Human Integration
- Strategic Oversight: Keep humans in the loop for critical decisions
- Explainable AI: Provide clear reasoning for all recommendations
- Continuous Learning: Incorporate human feedback for system improvement
Future Enhancements
1. Advanced AI Capabilities
- Integration of large language models for natural language reporting
- Machine learning models for predictive analysis
- Computer vision for document analysis
2. Enhanced Visualization
- AR/VR dashboards for immersive data exploration
- Real-time collaborative analysis environments
- Mobile-optimized interfaces
3. Expanded Coverage
- Integration with alternative data sources
- Cross-asset class analysis capabilities
- Global regulatory compliance modules
This implementation demonstrates how LangGraph can be leveraged to build sophisticated, enterprise-grade financial analysis systems that combine the power of AI with the reliability and compliance requirements of the financial services industry.